Was generatives Video noch immer nicht kann: Text, Zahlen, Logos und Diagramme
Videomodelle liefern schöne Aufnahmen, machen aber bei Schrift, Zahlen, Logos und Diagrammen noch immer Fehler. Warum das so ist und was Sie stattdessen tun.
Die wichtigsten Erkenntnisse
- Videomodelle sind außergewöhnlich gut bei Aufnahmen, bei denen nichts exakt stimmen muss. Markenbeiträge bestehen größtenteils aus Dingen, bei denen es darauf ankommt: Text, Zahlen, Logos und Diagramme.
- Die Fehler sind strukturell, nicht gelegentlich. Ein Modell zeichnet Buchstaben und Ziffern als Pixel, die richtig aussehen, und hält Bilder nur statistisch konsistent, sodass gerade Linien wackeln und Zahlen abdriften.
- Den Text hinterher in einem Editor einzublenden, repariert den Clip und holt die Person zurück, die der Generator ersetzen sollte.
- Die Aufteilung, die funktioniert: ein Modell für Sprache und Urteilsvermögen, eine gestaltete Vorlage für alles, was exakt sein muss.
Sehen Sie sich ein beliebiges Showreel für generatives Video an, und Sie sehen dieselben Arten von Einstellung: eine Drohne über einer Küstenlinie, ein langsames Heranfahren an ein Gesicht, ein Produkt, das sich im Studiolicht dreht. Sie sind wirklich schön, und sie sind alle dieselbe Art von Ding. Sie sind Aufnahmen. Nichts darin muss exakt stimmen.
Das Video, das ein Unternehmen an einem gewöhnlichen Dienstag braucht, ist ein anderes Objekt. Es ist eine Zahl, die gestiegen ist, ein Spielplan, eine Preisänderung, eine Neueröffnung, ein Ergebnis. Ein solcher Beitrag besteht fast ganz aus den Dingen, die generatives Video noch immer nicht kann: exakter Text, exakte Zahlen, ein exaktes Logo und ein Diagramm, das die Daten ist. Dieser Artikel erklärt, warum KI-Video bei diesen Dingen Fehler macht und warum das Problem strukturell ist und nicht eine Frage des Wartens auf das nächste Modell.
Die vier Dinge, die ein Markenbeitrag exakt treffen muss
| Element | Was „richtig“ bedeutet | Was ein Modell tendenziell erzeugt |
|---|---|---|
| Text | Ihre Worte, in Ihrer Schrift, in jedem Bild korrekt geschrieben | Buchstabenähnliche Formen, die nah dran sind, bis sie es nicht mehr sind |
| Zahlen | Die Zahl aus den Daten, vom ersten bis zum letzten Bild identisch | Eine plausible Zahl, die sich zwischen Bildern ändern kann |
| Logo | Ihre Datei, in Ihrer Farbe, in Ihrer Größe, innerhalb des sicheren Bereichs | Etwas, das Ihrem Logo ähnelt, mit abdriftenden Kanten |
| Diagramm | Balken und Linien, die die Werte sind, auf geraden Achsen | Eine diagrammförmige Zeichnung, deren Geometrie atmet |
Jedes davon ist für eine Marke eine harte Anforderung, und jedes liegt dort, wo ein generatives Modell am schwächsten ist. Das ist kein Pech; es folgt daraus, wie die Modelle funktionieren.
Warum das passiert
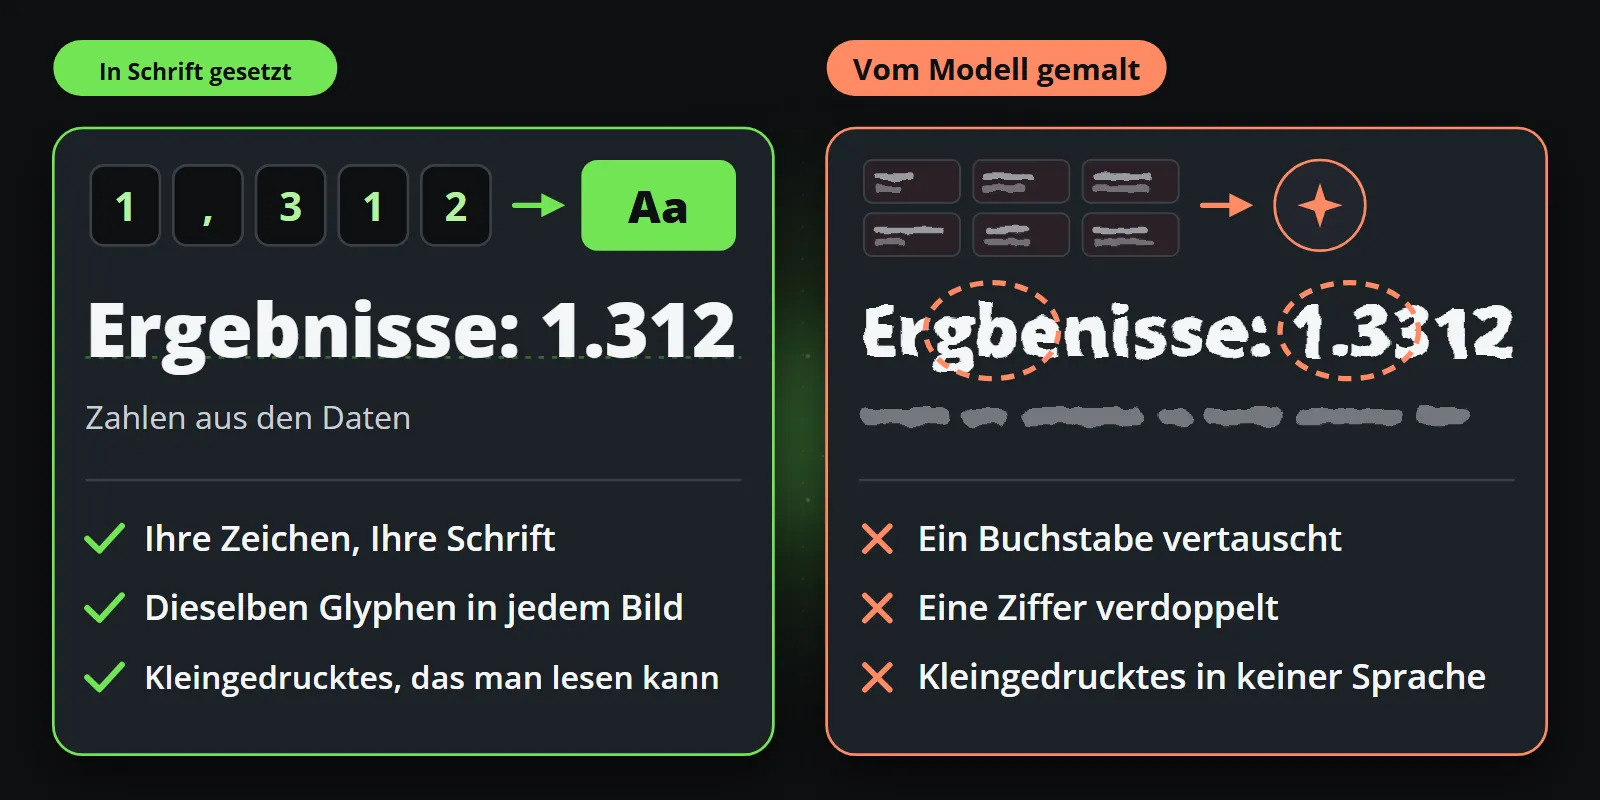
Text wird gezeichnet, nicht gesetzt
Ein Designwerkzeug setzt Text: Es nimmt Ihre Zeichen und Ihre Schrift und legt exakte Glyphen aus. Ein Videomodell hat weder Zeichen noch Schriften. Es hat in Millionen Bildern gelernt, wie Text aussieht, und malt Pixel, die ihm ähneln. Kurze, häufige Wörter gelingen oft. Lange Wörter, Markennamen, Zahlen und Kleingedrucktes, also genau das, was ein Markenbeitrag enthält, sind dort, wo es ausrutscht: ein vertauschter Buchstabe, eine verdoppelte Ziffer, eine Zeile Kleingedrucktes, die in keiner Sprache lesbar ist.
Jedes Bild wird aus seinen Nachbarn angenähert
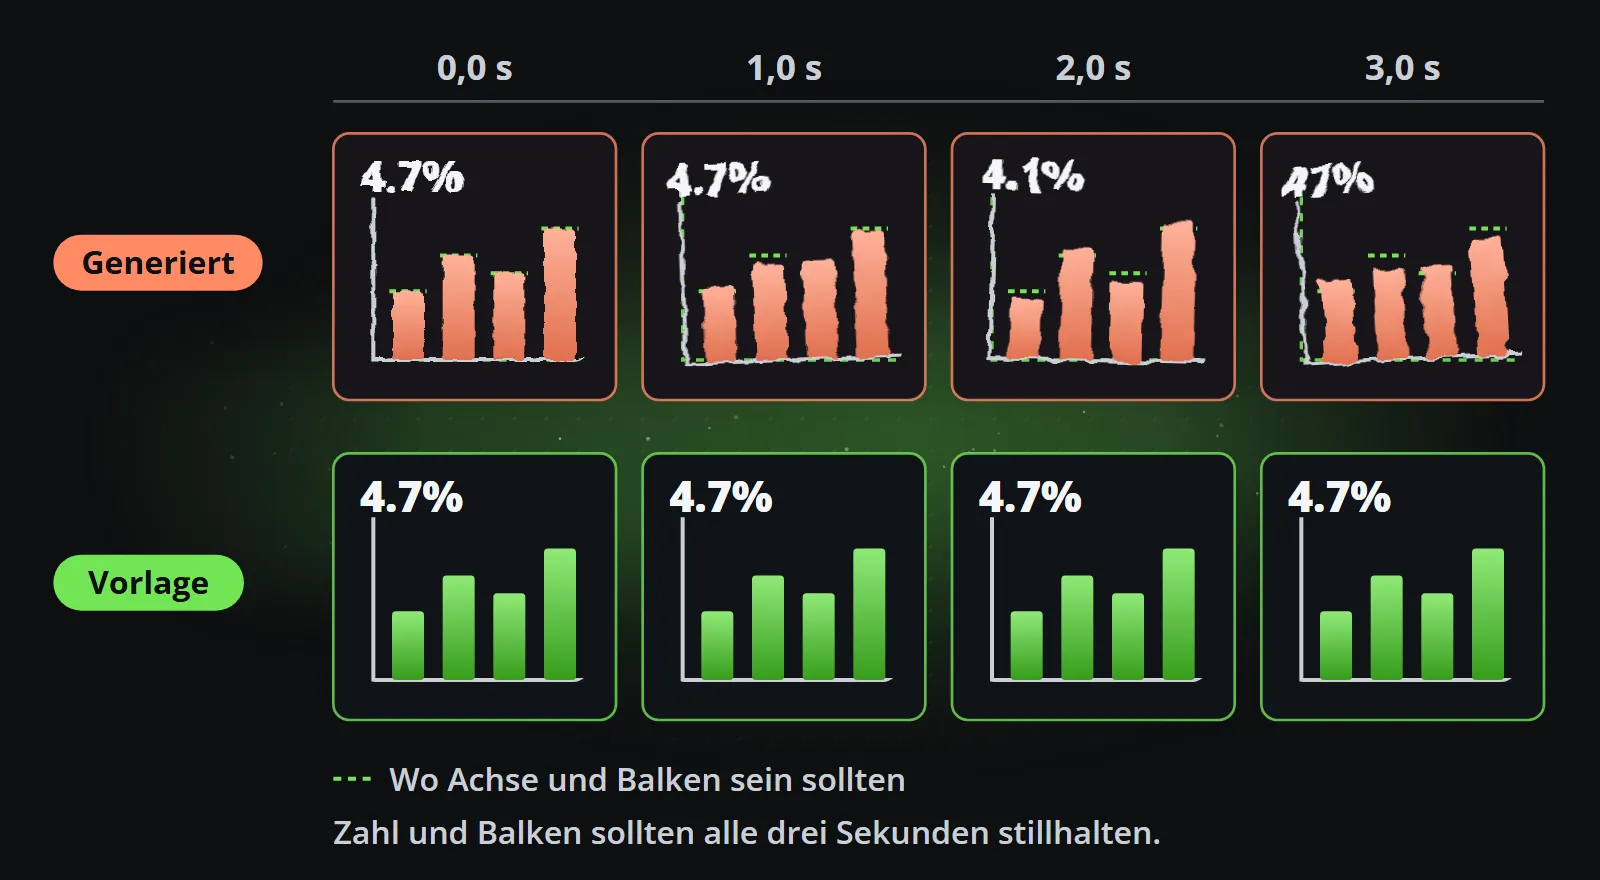
Ein Videomodell hält einen Clip kohärent, indem es jedes Bild mit den Bildern um es herum konsistent macht. Diese Konsistenz ist statistisch, nicht geometrisch. Bei einem Gesicht oder einer Welle ist sie unsichtbar. Bei einer geraden Achse, einem Balken, der seine Höhe halten muss, oder einer Zahl, die drei Sekunden lang gleich bleiben muss, zeigen sich kleine Unterschiede zwischen den Bildern als Wackeln und Driften, und Zuschauer bemerken sie innerhalb einer Sekunde.
Das Modell hat keine Daten
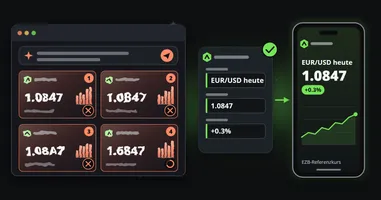
Wenn ein generierter Clip „4,7 %“ zeigt, weiß nichts im System, was der Wert sein sollte. Es gibt keinen Feed dahinter, nur einen Prompt. Die Zahl ist also nicht gelegentlich falsch; sie ist jedes Mal unbelegt, selbst wenn sie zufällig stimmt. Für ein reguliertes Unternehmen ist das eine Compliance-Frage, keine Designfrage.
Bewegung ist plausibel, nicht spezifiziert
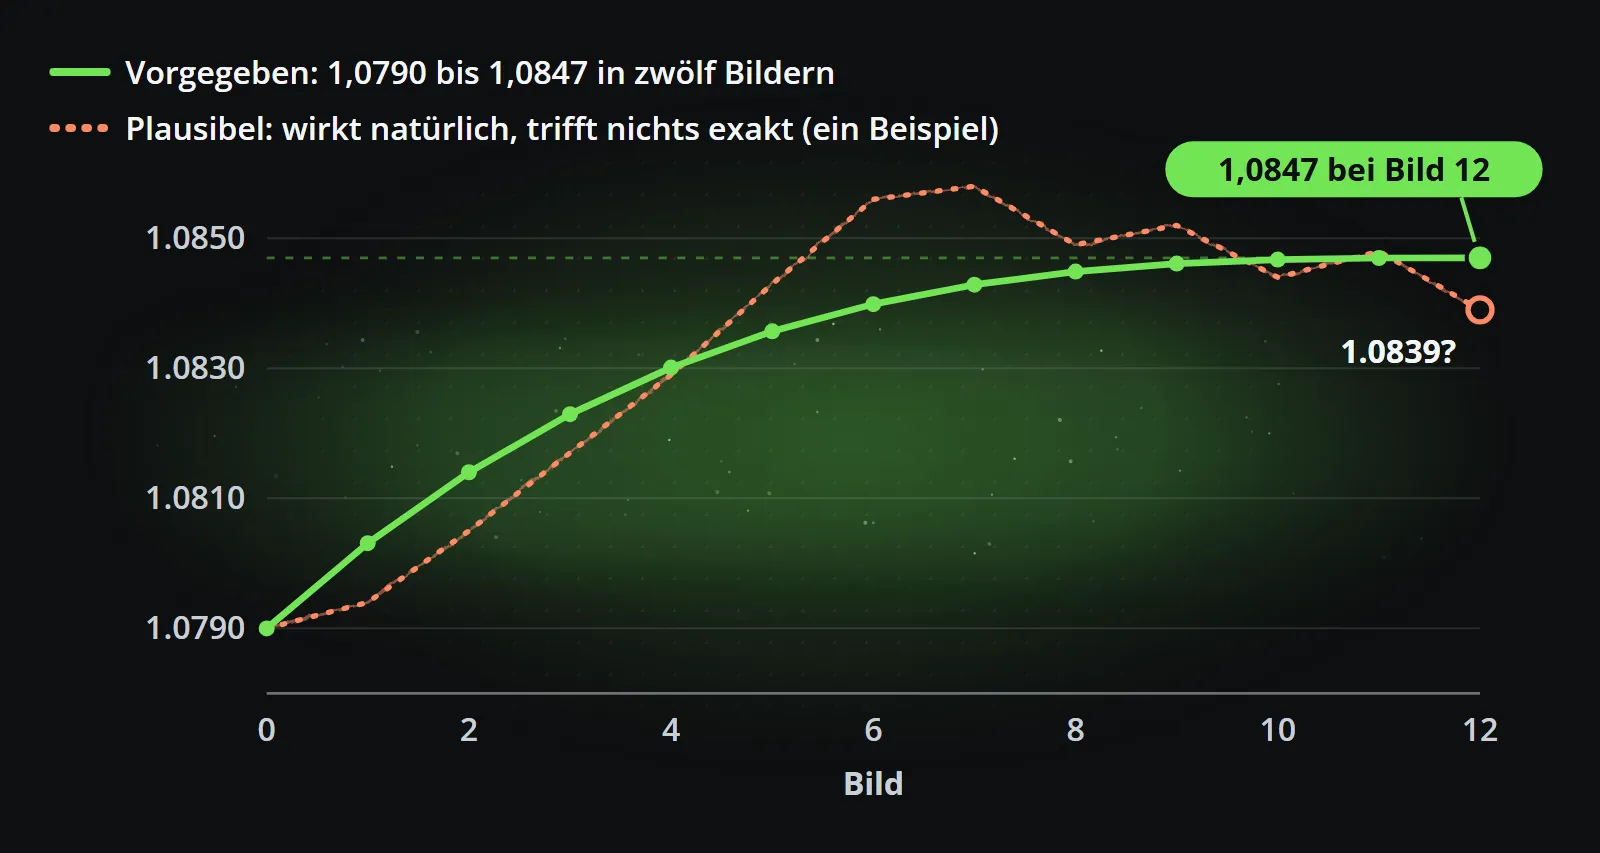
Datenanimation ist eine Spezifikation: Ein Wert zählt über zwölf Bilder von 1,0790 auf 1,0847, ein Balken wächst genau auf seinen Wert, eine Rangliste ordnet sich in definierter Reihenfolge neu. Ein Modell erzeugt Bewegung, die natürlich aussieht, und das ist ein anderes Ziel. Man kann ihm nicht vorgeben, auf einem Bild eine Zahl zu treffen.
Probieren Sie es selbst aus
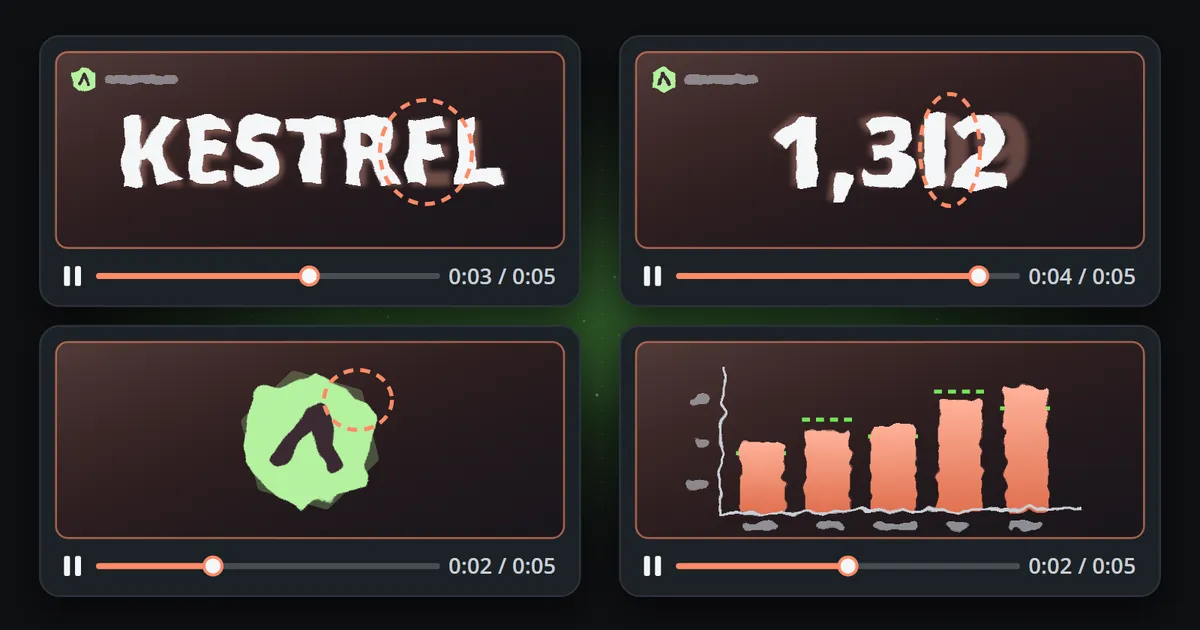
Wenn Sie das in Ihrem eigenen Zusammenhang sehen wollen, genügt ein Test von zehn Minuten. Bitten Sie ein beliebiges aktuelles Videomodell um diese vier Clips:
- Ihren Firmennamen groß auf einem einfachen Hintergrund, fünf Sekunden lang.
- Einen Zähler, der von 1.250 auf 1.312 steigt und stehen bleibt.
- Ihr Logo, als Referenzbild mitgegeben, das sich einmal dreht.
- Ein Balkendiagramm aus fünf Werten, die Sie vorgeben, mit Beschriftungen.
Halten Sie jeden Clip auf seinem schlechtesten Bild an. So sieht ein Screenshot Ihrer Marke aus.
Der übliche Umweg und warum er nicht skaliert
Die gängige Lösung ist, das Material ohne Text zu generieren und die Worte, Zahlen und das Logo anschließend in einem Editor hinzuzufügen. Das funktioniert, und das Ergebnis kann gut aussehen. Aber sehen Sie, was passiert ist: Der Generator hat den Hintergrund gemacht, und ein Mensch hat den Beitrag gemacht. Der Teil, der Zeit kostete, den Text zu setzen, die Zahl zu prüfen, das Logo zu platzieren, für jede Plattform zu untertiteln und die Größe anzupassen, liegt wieder auf dem Schreibtisch von jemandem.
Für einen gelegentlichen Clip ist das in Ordnung. Für einen Kanal, der jeden Tag postet, heißt es, dass der Generator den billigsten Teil der Arbeit gespart und den teuren dort gelassen hat, wo er war.
Die Aufteilung, die funktioniert
Die nützliche Antwort lautet nicht, dass KI bei Video nicht helfen kann. Sie lautet, dass die Aufgabe zwei Hälften hat, die an unterschiedliche Orte gehören.
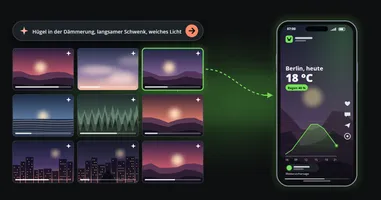
Sprache und Urteilsvermögen gehören einem Modell. Ein Ereignis lesen, entscheiden, dass es einen Beitrag wert ist, den Blickwinkel wählen, eine kurze Schlagzeile schreiben, Kanäle und Zeitpunkt auswählen: Das ist Urteilsvermögen über Text, und genau dafür ist ein Assistent da.
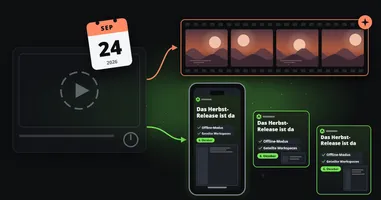
Alles Exakte gehört einer Vorlage. Eine einmal von einem Menschen gestaltete Komposition entscheidet, wo die Zahl sitzt, wie das Diagramm animiert wird, was passiert, wenn die Schlagzeile lang ist, und wie das Ganze von 16:9 auf 9:16 umbricht. Sie setzt Ihren Text in Ihrer Schrift, platziert Ihre Logodatei und zeichnet Balken so hoch wie ihre Werte.
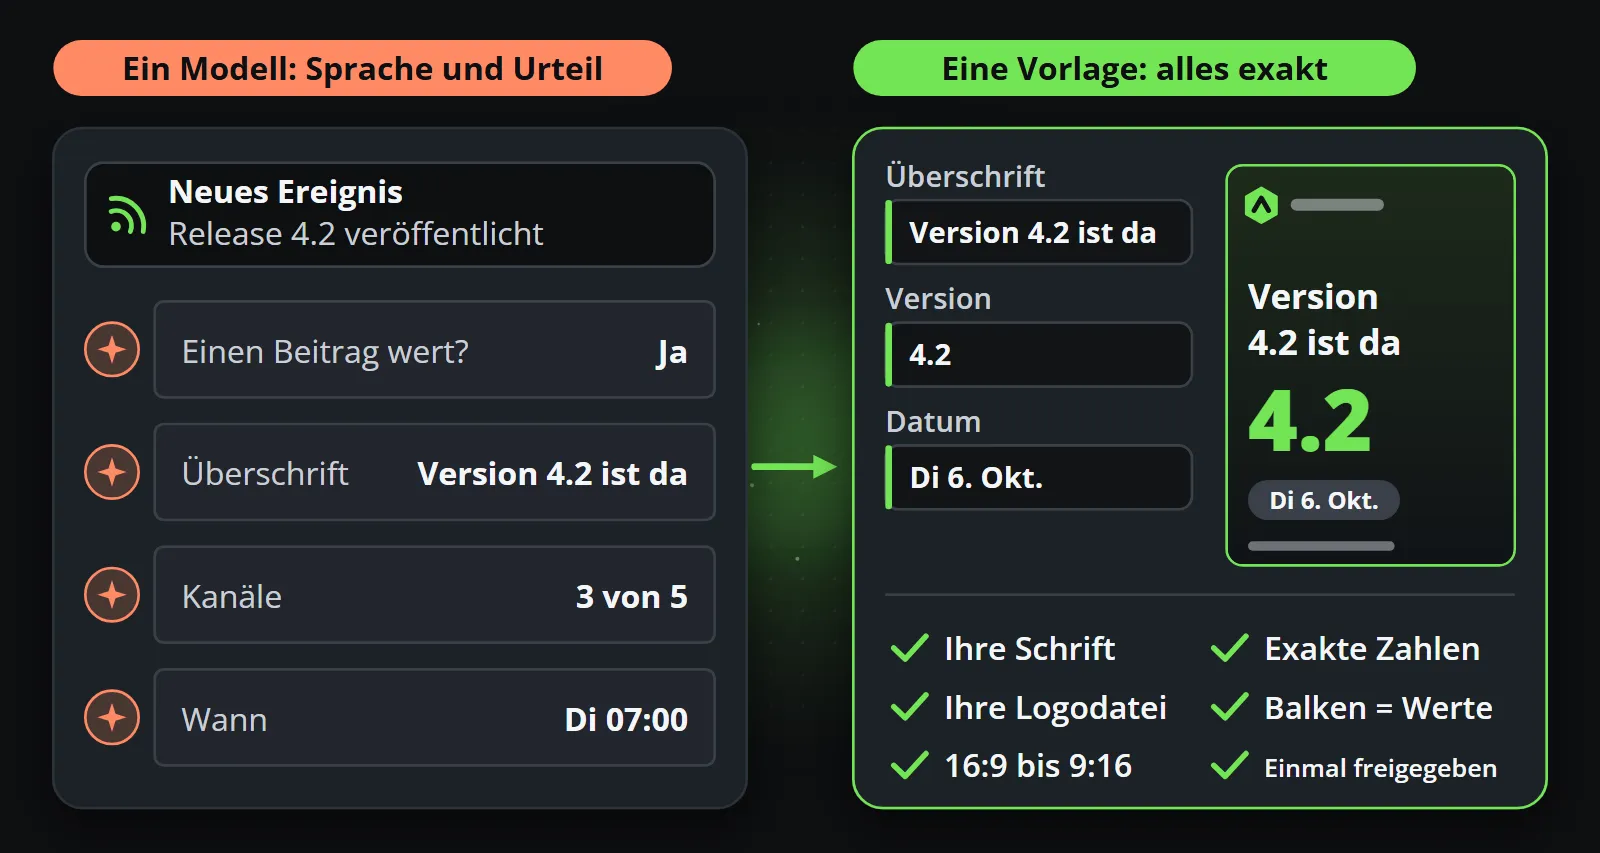
Geben Sie dem Assistenten die erste Hälfte und der Vorlage die zweite, und das Ergebnis ist ein Video, das es wert ist, veröffentlicht zu werden, und das sich sicher veröffentlichen lässt, ohne vorher jedes Bild anzusehen. So ist Reelwire gebaut: Ein Assistent kann den Workspace über MCP betreiben, und jeder Clip wird trotzdem aus einer freigegebenen Vorlage gezeichnet. KI-Videogenerator oder Vorlagenvideo vergleicht die Ansätze bei Kosten und Konsistenz, und MCP für Video zeigt die Assistentenhälfte.
Was das für die Prüfung bedeutet
Jeden dieser Fehler kann eine sorgfältige Person finden, die jeden Clip Bild für Bild ansieht. Das ist der Haken: Ein Prozess, der davon abhängt, sie zu finden, hängt von dieser Person ab, jedes Mal, in dem Tempo, in dem der Kanal veröffentlicht. Bei einem Clip pro Woche ist das machbar. Bei mehreren am Tag, über Formate und Sprachen hinweg, ist es eine Vollzeitstelle, und der Tag, an dem sie übersprungen wird, ist der Tag, an dem die falsche Zahl rausgeht. Ein Prüfprozess, der skaliert, prüft das Design einmal und vertraut den Daten, was nur möglich ist, wenn im Clip nichts improvisiert wird.
Wird das nächste Modell es beheben?
Modelle werden bei Text besser werden, und manche stellen kurze Schlagzeilen schon gut dar. Zwei Dinge ändern sich mit einem besseren Modell nicht. Eine generierte Zahl hat weiterhin keine Daten hinter sich, muss also weiterhin geprüft werden. Und ein probabilistisches Modell liefert weiterhin jedes Mal ein anderes Ergebnis, sodass jeder Clip weiterhin geprüft werden muss, bevor er rausgeht. Eine Vorlage ist deterministisch: Dieselben Daten ergeben immer denselben Clip, und genau das erlaubt es einem Prüfer, sie einmal freizugeben und ihr danach zu vertrauen.
Nutzen Sie generatives Video, wo Annäherung ein Vorzug ist, für Aufnahmen, Hintergründe und Ideen. Nutzen Sie Vorlagen, wo sie ein Risiko ist. Der kostenlose Tarif reicht, um den Unterschied an Ihren eigenen Zahlen zu sehen.
Häufig gestellte Fragen
Warum macht KI-generiertes Video bei Text Fehler?
Videomodelle setzen Text nicht in einer Schrift; sie zeichnen Pixel, die Buchstaben ähneln, gelernt aus Bildern. Kurze, häufige Wörter gelingen oft, aber lange Wörter, Namen, Zahlen und Kleingedrucktes driften oder ändern sich zwischen den Bildern.
Können KI-Videogeneratoren die richtigen Zahlen zeigen?
Nicht zuverlässig. Ein Modell hat keine Daten hinter der Zahl, die es zeichnet, und Ziffern können sich von Bild zu Bild ändern. Bei einem Preis, einem Ergebnis oder einer Statistik sollte die Zahl aus Daten stammen und von einer Vorlage gesetzt werden.
Kann KI-Video mein Logo exakt wiedergeben?
Meist nur annähernd. Kanten, Abstände und Farbe können zwischen den Bildern abdriften, selbst wenn das Logo als Referenzbild mitgegeben wird. Eine Vorlage setzt Ihre tatsächliche Logodatei, sodass sie in jedem Bild und jedem Clip identisch ist.
Wofür ist generatives Video gut?
Für Aufnahmen, bei denen Annäherung genügt: Establishing Shots, B-Roll, abstrakte Hintergründe, Konzepte und Moodboards. Eine einmal generierte Hintergrundschleife kann von jedem Clip auf Vorlagenbasis wiederverwendet werden.
Erstellen Sie noch heute Ihre ersten Clips
Im kostenlosen Tarif erhalten Sie 15 Clips im Monat, ohne Kreditkarte. Fügen Sie Ihr Logo und Ihre Farben hinzu, wählen Sie eine Vorlage und sehen Sie sich einen fertigen Clip im Design Ihrer Marke an, bevor Sie sich festlegen.
Mitgründer von Reelwire. Jede Organisation hat Fakten, die es wert sind, gezeigt zu werden: ihre Preise, Ergebnisse, Veröffentlichungen und Warnungen. Seine Vision ist, dass jede Organisation diese Fakten jeden Tag zeigen kann, markenkonform, in jedem Bildformat und jeder Sprache, ohne ein Produktionsteam hinter jedem Beitrag. Markenkonform, jeden Tag: korrekt, wiedererkennbar und einheitlich vom ersten bis zum tausendsten Clip.